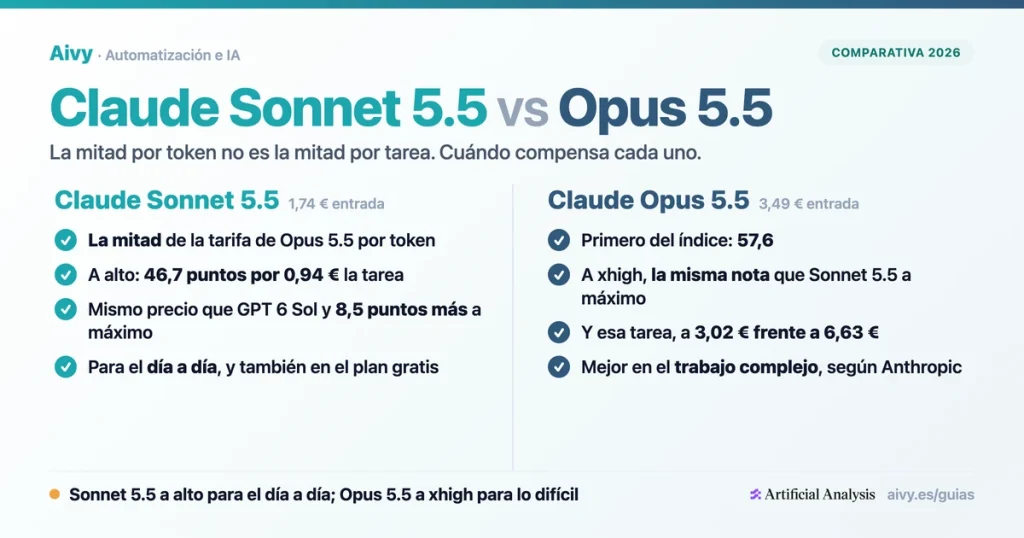
Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026 y lo presenta como el complemento más rápido y más barato de Opus 5.5. Sobre el papel, lo es: cobra justo la mitad por token de entrada y de salida. La tentación es pasarlo todo al barato. Si lo planteas como Sonnet 5.5 vs Opus 5.5, la cuenta sale bien en unos esfuerzos y mal en otros.
Dirijo Aivy, una agencia de automatización que nació en Melbourne y hoy trabaja con pymes españolas, y la cuenta fácil no me convence. Un modelo que cobra la mitad por token puede gastar muchos más tokens para terminar el mismo encargo. Con la versión 5 del índice de Artificial Analysis, Sonnet 5.5 a esfuerzo máximo saca menos nota que Opus 5.5 a muy alto, y su tarea cuesta 1,7 veces más.
Esta guía pone el dinero delante: tarifa y coste por tarea en euros, esfuerzo por esfuerzo, y separa lo que afirma Anthropic de lo que mide un tercero. Compara también Sonnet 5.5 con GPT 6 Sol, que cobra lo mismo por token. Mi resumen cabe en una línea: Sonnet 5.5 a alto para el día a día y Opus 5.5 a muy alto para lo más difícil.
Qué trae Claude Sonnet 5.5 frente a Sonnet 5
Claude Sonnet 5.5 es el segundo modelo de la familia Claude 5.5 y salió el 28 de septiembre, seis días después de Opus 5.5. Según Anthropic, destaca en las tareas del día a día acotadas, en arreglar fallos y en preparar documentos, diapositivas y hojas de cálculo. Opus 5.5 queda para el trabajo complejo que pide juicio cuidadoso. El tercero, Claude Haiku 5.5, llegó el 7 de octubre.
Frente a su predecesor, Sonnet 5, la tarifa no se mueve. Anthropic asegura que genera la salida más rápido y que, en la mayor parte del trabajo, cuesta hasta un 30% menos por tarea, porque suele necesitar muchos menos tokens para lo mismo. El ahorro llega por gastar menos, no por cobrar menos, y los testimonios que publica el fabricante apuntan ahí:
- Balyasny: en 2.441 tareas de finanzas, Sonnet 5.5 gastó unos 121.000 tokens por respuesta, frente a 497.000 de Sonnet 5.
- Slack: un 14% menos de tokens de salida.
- Box: un 12% menos de tokens en total que el modelo anterior.
- Ojo: son cifras de empresas que cita el fabricante, no mediciones independientes.
Sonnet 5.5 y Opus 5.5 comparten casi todo: un millón de tokens de contexto, 128.000 de salida máxima y el conocimiento cortado en junio de 2026. Se separan en el precio, en la latencia según la etiqueta de Anthropic, en el pensamiento (en Opus 5.5 no se apaga) y en el esfuerzo con el que arrancan en la API: alto en Sonnet 5.5, medio en Opus 5.5.
| Ficha | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Lanzamiento | 28 de septiembre de 2026 | 22 de septiembre de 2026 |
| Retirada | no antes del 28 de septiembre de 2027 | no antes del 22 de septiembre de 2027 |
| Entrada y salida, por millón | 1,74 € y 8,72 € | 3,49 € y 17,45 € |
| Lectura de caché, por millón | 0,09 € | 0,17 € |
| Escritura de caché (5 minutos y 1 hora) | 2,18 € y 3,49 € | 4,36 € y 6,98 € |
| Por lotes | la mitad en entrada y salida | la mitad en entrada y salida |
| Contexto | 1.000.000 de tokens | 1.000.000 de tokens |
| Salida máxima | 128.000 tokens | 128.000 tokens |
| Corte de conocimiento | junio de 2026 | junio de 2026 |
| Esfuerzo por defecto en la API | alto | medio |
| Latencia, en palabras de Anthropic | rápida | moderada |
| Para qué, según Anthropic | tareas del día a día bien acotadas, arreglar fallos, documentos, diapositivas y hojas de cálculo | trabajo complejo que pide juicio cuidadoso |
Fichas de Claude Sonnet 5.5 y Claude Opus 5.5, página de precios, notas de versión y anuncio de Anthropic, leídos el 28 de septiembre de 2026. Importes en euros convertidos al tipo del BCE del 22 de septiembre de 2026. La latencia es una etiqueta del fabricante, no una medida.
Precio en euros: la mitad por token
Lo que pagas en euros baila con el dólar. Al tipo del BCE del 22 de septiembre, Sonnet 5.5 cuesta 1,74 € por millón de tokens de entrada y 8,72 € de salida, lo mismo que Sonnet 5. Opus 5.5 cobra justo el doble: 3,49 € y 17,45 €. GPT 6 Sol y GPT 6.1 Sol cobran lo mismo que Sonnet 5.5 hasta los 272.000 tokens de entrada.
Sonnet 5.5 cuesta la mitad por token que Opus 5.5, y lo mismo que GPT 6.1 Sol
Euros por millón de tokens. Más bajo es más barato. Las seis barras a escala de la mayor, 17,45 €. Fuente: páginas de precios de Anthropic (leída el 28 de septiembre de 2026) y de OpenAI (ficha de GPT 6.1 Sol, leída el 29 de septiembre de 2026). Las dos publican y cobran en dólares; euros convertidos al tipo del BCE del 22 de septiembre de 2026.
Entrada, por millón de tokens
Salida, por millón de tokens
Leer de caché cuesta 0,09 € por millón en Sonnet 5.5 desde el 7 de octubre de 2026, 0,17 € en Opus 5.5 y 0,09 € en GPT 6.1 Sol. Por encima de 272.000 tokens de entrada, GPT 6.1 Sol cobra el doble en entrada y caché y 1,5 veces en salida; Anthropic no cobra recargo por contexto largo.
La letra pequeña está en la caché, que guarda lo que ya has enviado para no procesarlo entero en la siguiente petición. Con Sonnet 5.5 cuesta la mitad que con Opus 5.5 en las dos direcciones:
- Escribir en la caché de cinco minutos: 2,18 € frente a 4,36 € por millón de tokens.
- Leer de ella: 0,09 € frente a 0,17 €, desde el 7 de octubre de 2026.
- Dónde se nota: si tu asistente relee una y otra vez el mismo contrato, esa parte de la factura baja al pasar a Sonnet.
Otro mando abarata mucho. La API de lotes, para trabajos que pueden esperar, descuenta un 50% en la entrada y la salida, y con Sonnet 5.5 deja subir la salida máxima a 300.000 tokens, en beta. Para una asesoría o gestoría que clasifica facturas o resume expedientes de noche, es el primer descuento que yo miraría. Y no hay recargo por contexto largo en ninguno de los dos.
Por qué la tarifa no es tu factura
Un token es un trozo de texto, y la API cobra los que envías y los que escribe el modelo, razonamiento incluido. La factura es la tarifa por los tokens que necesita para terminar, y eso lo decide él, como un fontanero que cobra la mitad por hora pero tarda el doble. Y gasta más o menos según el esfuerzo: bajo, medio, alto, muy alto (xhigh) o máximo.
Artificial Analysis, un evaluador independiente, ejecuta su índice de inteligencia, ya en la versión 5, con cada modelo y cada esfuerzo, y publica la nota y lo que costó cada tarea a precio de tarifa. Tus tareas no son las suyas, así que no es tu factura; sirve para comparar a los dos con las mismas reglas. Con Sonnet 5.5, la tarea va de 0,46 € a bajo a 9,00 € a máximo.
Nivel a nivel, Sonnet 5.5 sale más barato por tarea en todos los esfuerzos
Coste por tarea del índice de inteligencia v5 de Artificial Analysis, en euros, por nivel de esfuerzo. Más bajo es más barato. Barras a escala de la mayor, 9,02 €. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de octubre de 2026. AA lo publica en dólares; euros convertidos al tipo del BCE del 28 de octubre de 2026.
Esfuerzo bajo
Esfuerzo medio
Esfuerzo alto
Esfuerzo muy alto
Esfuerzo máximo
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Nivel contra nivel, Sonnet 5.5 cuesta menos por tarea en bajo, medio, alto y muy alto. Pero comparar el mismo nivel engaña, porque no sacan la misma nota: Opus 5.5 rinde más en cada escalón. La pregunta útil no es cuál cuesta menos a igual esfuerzo, sino cuál llega a la nota que necesitas por menos dinero. Para ver qué supone en tu volumen, tienes la calculadora de ROI.
Opus 5.5 saca más nota que Sonnet 5.5 en cada nivel de esfuerzo
Índice de inteligencia v5 de Artificial Analysis por nivel de esfuerzo. Más alto es mejor. Barras a escala de la mayor, 58,4. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de octubre de 2026.
Esfuerzo bajo
Esfuerzo medio
Esfuerzo alto
Esfuerzo muy alto
Esfuerzo máximo
En esa lectura, por encima de los dos quedaba Gemini 4 Carbon, con 59,4 a alto y aún sin contratar. El 9 de noviembre llegó Claude Fable 5.2, con 64,6 a máximo.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Bajo: Sonnet 5.5 marca 25,3 por 0,46 € la tarea, lo más barato de los dos modelos.
- Medio, ya sin trampa: es el esfuerzo con el que Sonnet 5.5 arranca en las apps de Claude y en Claude Code. Marca 30,3 por 0,70 €, y Opus 5.5 a bajo saca 34,5 por 0,88 €: algo más de nota, pero ya por un 25% más.
- Alto, donde Sonnet 5.5 no tiene rival: 41,1 por 1,47 €, y ningún ajuste de Opus 5.5 da esa nota por menos. Opus 5.5 a medio, su ajuste de fábrica en la API, saca 48,1 por 2,20 €: 7,0 puntos más por un 50% más.
- Muy alto, otra vez la trampa: Sonnet 5.5 da 49,6 por 3,68 €, y Opus 5.5 a alto, 51,7 por 3,11 €.
A máximo, un 66% más y menos nota
Si solo te quedas con un dato, que sea este. Sonnet 5.5 a máximo saca 54,2 en la versión 5 del índice de Artificial Analysis. Opus 5.5 a muy alto saca 57,0: casi tres puntos más. Y la tarea de Sonnet 5.5 cuesta 9,00 € y la de Opus 5.5, 5,43 €. Pagas 1,7 veces más por menos nota o, mirado al revés, Opus 5.5 sale un 39,7% más barato.
A máximo, Sonnet 5.5 cuesta un 66% más por tarea que Opus 5.5 a muy alto
Coste por tarea del índice de inteligencia v5 de Artificial Analysis, en euros; la nota del índice va en la etiqueta. Más bajo es más barato. Barras a escala de la mayor, 9,02 €. Fuente: Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de octubre de 2026; euros convertidos al tipo del BCE del 28 de octubre de 2026.
Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
Y Opus 5.5 a máximo, con 58,4, cuesta 9,02 € la tarea: más nota que Sonnet 5.5 a máximo por casi el mismo dinero. Con la mitad de tarifa por token, eso solo cuadra de una manera: para acercarse a Opus 5.5, Sonnet 5.5 gasta más tokens. La escalera de Opus 5.5 ya la desmenuzamos en su duelo con Fable 5.1.
Aquí Anthropic y Artificial Analysis no cuentan lo mismo. El fabricante escribe que, en los ajustes altos, Sonnet 5.5 puede rendir como Opus 5.5 a un coste parecido. En el índice independiente, Sonnet 5.5 a máximo cuesta un 66% más por tarea que Opus 5.5 a muy alto, y saca menos nota. No es que uno mienta: miden tareas distintas. Pero yo no usaría la palabra parecido, y lo comprobaría con tareas propias.
Qué dice cada benchmark y quién lo firma
En su anuncio, Anthropic publica una tabla propia con cuatro modelos, y lo primero que salta es la distancia con Sonnet 5: en Terminal Bench 4.0, de programación agéntica, pasa de un 10,3% a un 70,6%. En GDPval AA, trabajo real de 44 ocupaciones en nueve grandes sectores, queda unos 400 puntos por encima y casi a la par de Opus 5.5: 1.844 frente a 1.846.
| Prueba | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT 6 Sol |
|---|---|---|---|---|
| Terminal Bench 4.0 (programación agéntica) | 70,6% | 10,3% | 66,4% (a muy alto) | sin dato |
| FrontierCode 1.1, conjunto principal | 46,2% a máximo; 52,1% a muy alto | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | sin dato |
| GDPval AA v2.1 (Elo) | 1.844 | 1.449 | 1.846 | 1.487 |
| AA Briefcase v1.1 (Elo) | 1.811 | 1.359 | 1.822 | 1.483 |
| Humanity’s Last Exam, con herramientas | 64,5% | 54,9% | 67,7% | sin dato |
| OSWorld 2.1 (uso del ordenador, puntuación parcial) | 80,1% | 57,0% | 81,8% | sin dato |
| Chartography (gráficos, sin herramientas) | 61,6% | 15,6% | 64,4% | 53,6% |
Cifras publicadas por Anthropic en el anuncio de Claude Sonnet 5.5, 28 de septiembre de 2026; el esfuerzo solo se indica donde Anthropic lo indica. Sin dato: Anthropic no lo publica. GDPval AA y AA Briefcase las ejecutó Artificial Analysis y las publica Anthropic: no son lecturas nuestras de su tablero. Artificial Analysis no avala este análisis ni es responsable de él.
- Frente a Opus 5.5, donde gana: solo en Terminal Bench 4.0, con un 70,6% contra el 66,4% que Opus 5.5 saca en su mejor ajuste.
- Frente a Opus 5.5, donde pierde por poco: en CursorBench se queda a unos dos puntos; en OSWorld, de uso del ordenador, marca un 80,1% frente a un 81,8%, y en FrontierCode su mejor nota, un 52,1%, no llega al 54,4%.
Contra Sonnet 5, el salto se veía también en la v4.3 del índice de Artificial Analysis, la última que lo midió: a máximo, Sonnet 5.5 marcaba 17,8 puntos más por solo un 7% más de coste, sin desmentir el hasta un 30% menos de Anthropic, que mide su trabajo típico. Su otra promesa, la mejor nota de Sonnet 5 por una décima parte del coste, se cumplía a medio: 40,74 por 0,42 €, frente a 4,44 €.
Para programar falta una pieza: el índice de programación de Artificial Analysis aún no tiene nota de Sonnet 5.5 ni de Opus 5.5, así que solo hay cifras del fabricante, con ventaja de Opus 5.5 en FrontierCode y CursorBench y de Sonnet 5.5 en Terminal Bench 4.0. Yo probaría los dos con código propio, y si aún dudas de herramienta, mira Claude Code frente a Codex.
Sonnet 5.5 frente a GPT 6.1 Sol: mismo precio, otra nota
En la gama GPT 6, Sol es el rival directo de Sonnet 5.5: cobra lo mismo por token. En la tabla de Anthropic, Sonnet 5.5 gana con holgura en GDPval AA, AA Briefcase y Chartography, aunque avisa de que OpenAI corrigió un fallo de Sol con imágenes y esas notas pueden no estar al día. En FrontierCode, a muy alto, 52,1% frente a 49,3%; a máximo, Sol queda por delante.
| Modelo | Entrada y salida, por millón | Índice de AA a máximo | Coste por tarea a máximo |
|---|---|---|---|
| Claude Sonnet 5.5 | 1,74 € y 8,72 € | 54,2 | 9,00 € |
| Claude Opus 5.5 | 3,49 € y 17,45 € | 58,4 | 9,02 € |
| GPT 6.1 Sol | 1,74 € y 8,72 € | 54,5 | 1,14 € |
| Gemini 4 Carbon (alto, sin acceso) | 1,80 € y 8,98 € de lanzamiento | 59,4 | 6,97 € |
Tarifas de Anthropic y OpenAI al tipo del BCE del 22 de septiembre de 2026; la de lanzamiento de Gemini 4 Carbon y el coste por tarea, al del 28 de octubre. Índice y coste por tarea: Artificial Analysis (artificialanalysis.ai), versión 5, leída el 28 de octubre de 2026, a esfuerzo máximo salvo Carbon, medido solo a alto. GPT 6 Sol y Claude Sonnet 5 no tienen nota en esta versión. Artificial Analysis no avala este análisis ni es responsable de él.
En la versión 5 del índice independiente, a máximo, GPT 6.1 Sol ya saca algo más que Sonnet 5.5, 54,5 frente a 54,2, y su tarea cuesta casi ocho veces menos: 1,14 € frente a 9,00 €. Mismo precio por token, factura muy distinta. GPT 6 Sol, el de la tabla de Anthropic, ya no tiene nota en esta versión.
Con la versión 5, la ventaja de Sonnet 5.5 en el índice desaparece: GPT 6.1 Sol saca más nota en cada esfuerzo y cuesta menos por tarea. A Sonnet 5.5 le quedan las pruebas de Anthropic de arriba y que, por encima de 272.000 tokens de entrada, Sol cobra el doble en entrada y caché y 1,5 veces en salida. Si tu duda es de app y no de API, mira Claude frente a ChatGPT.
- GPT 6.1 Sol, desde el 29 de septiembre: la versión mejorada de Sol y hoy el rival de OpenAI al mismo precio.
- A muy alto: saca más que Sonnet 5.5, 52,3 frente a 49,6, y su tarea cuesta 0,69 € frente a 3,68 €.
- A alto: marca 50,2 por 0,53 €, y Sonnet 5.5, 41,1 por 1,47 €.
- A máximo: casi empatan, 54,5 frente a 54,2, pero a 1,14 € la tarea frente a 9,00 €.
Qué modelo y qué esfuerzo para cada trabajo
Anthropic recomienda con una reserva a favor de Opus. Según el anuncio, Sonnet 5.5 complementa mejor a Opus 5.5 a esfuerzos bajos, donde cuesta menos por tarea, y en sus pruebas y en las de probadores externos Opus 5.5 sigue siendo claramente más fuerte en el trabajo complejo y abierto que pide juicio sostenido. Que lo diga el día que lanza Sonnet 5.5 le da más peso.
Con eso y con los datos de arriba, yo ordenaría la decisión como una escalera. Empiezas por lo barato y subes solo cuando tus pruebas demuestran que el escalón de abajo se queda corto. La tabla pone a cada peldaño su nota y su coste por tarea en Artificial Analysis; la columna del tipo de trabajo es criterio mío, no del fabricante ni del evaluador.
| Tipo de trabajo | Por dónde empezaría | Índice de AA · coste por tarea |
|---|---|---|
| Mucho volumen y poca dificultad: clasificar, extraer, resumir | Sonnet 5.5 a bajo | 25,3 · 0,46 € |
| Si Sonnet 5.5 a bajo se queda corto | Opus 5.5 a bajo | 34,5 · 0,88 € |
| Tareas acotadas del día a día: correos, informes, fallos sencillos | Sonnet 5.5 a alto | 41,1 · 1,47 € |
| Trabajo serio con criterio: análisis, código de varios ficheros | Opus 5.5 a medio o alto | 48,1 · 2,20 € y 51,7 · 3,11 € |
| Lo más difícil: agentes largos, decisiones caras | Opus 5.5 a muy alto (xhigh) | 57,0 · 5,43 € |
| Lo que no recomiendo | Sonnet 5.5 a máximo | 54,2 · 9,00 € |
Recomendación de Aivy. Cifras: índice de inteligencia v5 y coste por tarea de Artificial Analysis (artificialanalysis.ai), datos leídos el 28 de octubre de 2026; euros convertidos al tipo del BCE del 28 de octubre de 2026. Basado en datos de Artificial Analysis. Artificial Analysis no avala este análisis ni es responsable de él.
- Abajo, Sonnet 5.5 a bajo: para trabajo repetitivo con una respuesta fácil de comprobar, como clasificar correos o extraer campos de albaranes. Es el terreno de la automatización documental: si una regla valida el resultado, pagar más nota no sale a cuenta. Si falla, Opus 5.5 a bajo cuesta casi el doble, 0,88 € la tarea, y puntúa más.
- Por debajo, Claude Haiku 5.5: desde el 7 de octubre de 2026, a 0,09 € de entrada y 0,44 € de salida por millón con prompts de hasta 100.000 tokens. En la versión 5 del índice de Artificial Analysis saca 36,2 a máximo, más que Sonnet 5.5 a medio, y su tarea cuesta 0,37 €. Para clasificar y extraer a volumen, es el primero que probaría yo.
- El día a día, Sonnet 5.5 a alto: encaja con lo que Anthropic le atribuye, tareas acotadas, fallos, documentos y hojas de cálculo. Lo de alto es criterio mío, por el índice, no de Anthropic.
- Si alto se queda corto, cambia de modelo: no subiría Sonnet 5.5 a muy alto, porque Opus 5.5 a alto le gana en nota y cuesta menos por tarea. Pasaría a Opus 5.5 a medio o alto para lo que ya no está tan acotado, como un informe que cruza varias fuentes o un cambio de código que toca varios módulos. El resto de la gama lo repasa nuestra guía de qué modelo de Claude usar.
- Arriba, Opus 5.5 a muy alto: para lo más difícil, 57,0 por 5,43 € la tarea, y a máximo solo cuando un punto más de nota se traduce en dinero o en riesgo. En OpenAI, GPT 6 Astra a máximo marca 56,9 por 5,61 €, por debajo de Opus 5.5 a muy alto.
- Nunca, Sonnet 5.5 a máximo: si alguien lo tiene puesto por si acaso, es el primer ajuste que revisaría.
Un detalle práctico: en la API, Sonnet 5.5 ya arranca en alto, pero en las apps y en Claude Code arranca en medio, y a alto rinde bastante más por poco dinero. Así que súbelo a mano: en la app, desde el menú de modelo junto al botón de enviar; en Claude Code, con /effort. Ojo si lo comparas con GPT 6.1 Terra, que arranca en medio.
Qué significa para las empresas españolas
Según la página de Sonnet de Anthropic, cualquiera puede usar Sonnet 5.5 en Claude.ai, en web, iOS y Android, y la página de planes lo incluye también en el gratuito. Opus 5.5 pide un plan de pago, y Claude Pro cuesta 18 € al mes sin IVA. Lo que Anthropic no dice es si Sonnet 5.5 pasa a ser el modelo por defecto de la app.
Si tratas datos personales, dónde se procesan importa de cara al RGPD, y la respuesta no es cómoda: hoy no hay forma de procesar solo en Europa con la API directa de Anthropic, ni para Sonnet 5.5 ni para Opus 5.5. Estas son las vías:
- API directa de Anthropic: inferencia global, la de serie, o en Estados Unidos, que cuesta 1,1 veces la tarifa. El espacio de trabajo, donde se guardan los datos, solo puede estar en Estados Unidos.
- Una gran nube: Sonnet 5.5 está en AWS, Google Cloud y Microsoft Azure, y en Bedrock y Google Cloud los puntos de acceso regionales cuestan un 10% más que los globales.
- Regiones europeas: cuáles sirven ya Sonnet 5.5 en cada nube no lo dicen las fuentes de esta guía. Míralo en la consola de cada una antes de firmar nada, sin darlo por supuesto.
La retención es otra cosa. Sonnet 5.5 está disponible con retención cero de datos, igual que Opus 5.5 y Sonnet 5, pero que el proveedor no guarde lo que le mandas no dice nada de dónde lo procesa. Son dos compromisos distintos, y conviene no mezclarlos en un contrato ni en un registro de actividades. Lo básico del RGPD y el AI Act lo tienes en nuestra guía de cumplimiento.
Pasar de Sonnet 5 sin romper nada
Si tienes código escrito para Sonnet 5, cambiar el nombre del modelo en la llamada no basta. Según las notas de versión de la API, hay cinco maneras de que se rompa, y una sexta trampa aparte:
- Pensamiento previo: para apagarlo ya no se manda
disabled, sinobetween_tools, que solo funciona a esfuerzo alto o menos. - Herramientas forzadas:
tool_choiceenanyotooldevuelve un error 400. - Bloques de pensamiento: van atados al modelo y a la conversación, y solo sirven en la cuenta que los generó o en una vinculada.
- Uso del ordenador: en la API de Claude y en Google Cloud ya no se acepta la herramienta antigua,
computer_20251124. - Advisor: la herramienta rechaza como asesores a Opus 4.8, Opus 4.7 y Sonnet 5.
- Y aparte:
temperature,top_potop_kfuera de su valor predeterminado también dan error 400.
En Claude Code, Sonnet 5.5 no es el modelo por defecto en ningún plan: arranca con Opus 5.5 en Pro, Max, Team, Enterprise y la API de Anthropic, y también en Amazon Bedrock, Google Cloud y Claude Platform on AWS. Sonnet 5.5 se elige con /model sonnet desde la versión 2.1.284. El modo opusplan usa Opus para planificar y Sonnet para ejecutar dentro de una misma sesión.
Y una trampa para quien trabaja a través de una nube: el alias sonnet solo apunta a Sonnet 5.5 en la API de Anthropic. En Claude Platform on AWS apunta a Sonnet 4.6, y en Amazon Bedrock, Google Cloud y Microsoft Foundry, a Sonnet 4.5. Si quieres el nuevo, fija la versión a mano; si no, harás tus pruebas con un Sonnet anterior sin saberlo.
Echa las cuentas por tarea, no por token
Sería cómodo resumir Sonnet 5.5 como un Opus a mitad de precio, y los datos no lo permiten. Cobra la mitad por token, pero lo que pagas depende de cuántos tokens gasta, y eso lo decide el esfuerzo. A bajo, medio y alto es la mejor compra; a muy alto y máximo, siempre hay un ajuste de Opus 5.5 que da más nota por menos dinero. Y por encima quedan Claude Fable 5.2, desde el 9 de noviembre, y Gemini 4 Carbon, aún sin vender.
Para una pyme, mi reparto: Sonnet 5.5 a alto para el trabajo de cada día, fijado a mano donde arranque en medio, y a bajo para el volumen fácil de comprobar. Opus 5.5 para lo que pide juicio, a muy alto si es lo más difícil. Y entre los dos, una muestra de tareas reales para ver dónde cae el corte, que es por donde empieza cualquier consultoría de IA.
Las notas son del lanzamiento; los costes, del 18 de octubre, salen de pruebas ajenas y los euros se moverán con el dólar. El tablero cambia a menudo, y desde el 7 de octubre la gama tiene también Haiku 5.5, así que vuelve a echar números antes de tocar producción. Si quieres repartir tus cargas entre los dos modelos con tus datos, reserva una llamada y lo vemos.
Sonnet 5.5 vs Opus 5.5: preguntas frecuentes
¿Cuánto cuesta Claude Sonnet 5.5 en euros?
Al tipo del BCE del 22 de septiembre de 2026, Sonnet 5.5 cuesta 1,74 € por millón de tokens de entrada y 8,72 € por millón de salida, lo mismo que Sonnet 5. Es la mitad que Opus 5.5, que cobra 3,49 € y 17,45 €. La API de lotes descuenta un 50%. Anthropic cobra en dólares, así que el importe en euros se mueve con el cambio.
¿Cuál gasta menos por tarea, Sonnet 5.5 u Opus 5.5?
Depende del esfuerzo. Con la versión 5 del índice de Artificial Analysis y frente a Opus 5.5, Sonnet 5.5 gana a bajo, con 0,46 € la tarea, y a alto, con 41,1 puntos por 1,47 €. A muy alto y máximo siempre hay un ajuste de Opus 5.5 con más nota por menos dinero. A máximo, Sonnet 5.5 cuesta 9,00 € la tarea; Opus 5.5 a muy alto, con más nota, 5,43 €.
¿Cuál es mejor para programar?
No hay veredicto independiente: el índice de programación de Artificial Analysis aún no ha medido a ninguno de los dos. En la tabla de Anthropic, Sonnet 5.5 gana en Terminal Bench 4.0, con un 70,6% frente a un 66,4%, y Opus 5.5 va delante en FrontierCode y CursorBench. Son cifras del fabricante: yo probaría los dos con código propio antes de decidir.
¿Sonnet 5.5 está en mi plan de Claude, también en el gratuito?
Sí. Según la página de Sonnet de Anthropic, cualquiera puede usar Sonnet 5.5 en Claude.ai, y la página de planes incluye Sonnet también en el gratuito. Opus 5.5 solo está en los planes de pago, y Claude Pro cuesta 22 € al mes con IVA en España. Lo que Anthropic no aclara es si Sonnet 5.5 pasa a ser el modelo por defecto de la app.
¿Sonnet 5.5 sustituye a Opus 5.5?
No. Anthropic lo presenta como un complemento más rápido y más barato, fuerte en tareas acotadas del día a día, fallos, documentos y hojas de cálculo. Para el trabajo complejo y abierto que pide juicio sostenido, dice que Opus 5.5 sigue siendo claramente más fuerte. Y a igual nota en Artificial Analysis, Opus 5.5 a muy alto cuesta menos de la mitad por tarea que Sonnet 5.5 a máximo.
¿Y si Opus 5.5 a máximo se queda corto?
Entonces el siguiente escalón es Claude Fable 5.2, del 9 de noviembre de 2026. Según Artificial Analysis, a alto saca 61,8 por 8,11 € la tarea, más nota que Opus 5.5 a máximo, y a bajo, 53,9 por 2,77 €. Por token cobra el doble que Opus 5.5, así que Anthropic lo reserva para lo más exigente.
¿Qué modelo usa Claude Code por defecto?
Claude Opus 5.5, en Pro, Max, Team, Enterprise y la API de Anthropic. Sonnet 5.5 no es el predeterminado en ningún plan: se elige con /model sonnet y pide la versión 2.1.284 o posterior. Ojo, porque el alias sonnet solo apunta a Sonnet 5.5 en la API de Anthropic; en Bedrock, Google Cloud o Microsoft Foundry apunta a un Sonnet anterior y hay que fijar la versión a mano.
¿Qué cambia en la API al pasar de Sonnet 5 a Sonnet 5.5?
Cinco cosas pueden romper tu código. El pensamiento previo se apaga con between_tools, no con disabled. Forzar herramientas da error 400. Los bloques de pensamiento van atados al modelo y a la conversación. La herramienta antigua de uso del ordenador ya no vale en la API de Claude ni en Google Cloud. Y advisor rechaza como asesores a Opus 4.8, Opus 4.7 y Sonnet 5.
¿Es mejor Sonnet 5.5 que GPT 6 Sol?
Ya no, en el índice de Artificial Analysis. GPT 6 Sol no tiene nota en su versión 5, y GPT 6.1 Sol, que lo sustituye con la misma tarifa por token, saca más que Sonnet 5.5 en cada esfuerzo: a máximo, 54,5 frente a 54,2, con una tarea de 1,14 € frente a 9,00 €. A Sonnet 5.5 le quedan las pruebas de Anthropic y que, por encima de 272.000 tokens de entrada, Sol cobra más.
Última actualización: 9 de noviembre de 2026
- Anthropic, anuncio de Claude Sonnet 5.5: posicionamiento frente a Opus 5.5, la mejora de velocidad y el hasta un 30% menos por tarea frente a Sonnet 5, la tabla de pruebas con sus notas al pie, esfuerzos por defecto, salvaguardas, retención cero, disponibilidad y el anuncio de Haiku 5.5. 28 de septiembre de 2026.
- Anthropic, anuncio de Claude Haiku 5.5: lanzamiento, precio con el tramo por encima de 100.000 tokens y la rebaja de la lectura de caché de Sonnet 5.5. 7 de octubre de 2026.
- Anthropic, ficha de Claude Sonnet 5.5: contexto, salida máxima, corte de conocimiento, esfuerzo por defecto, latencia según Anthropic, tarifas completas y fecha de retirada. Leída el 28 de septiembre de 2026.
- Anthropic, ficha de Claude Opus 5.5: lanzamiento, fecha de retirada, esfuerzo por defecto y pensamiento siempre activo. Leída el 28 de septiembre de 2026.
- Anthropic, notas de versión de la Claude Platform: los cinco cambios que pueden romper código escrito para Sonnet 5 y los bloques de pensamiento atados a la cuenta, leídas el 28 de septiembre de 2026; la lectura de caché de Sonnet 5.5 a 0,10 dólares por millón, el 7 de octubre.
- Anthropic, precios de la API: tarifas, lotes, que todos los precios van en dólares, la ausencia de recargo por contexto largo y el 10% de los puntos de acceso regionales de Amazon Bedrock y Google Cloud. Leída el 28 de septiembre de 2026.
- Anthropic, residencia de datos: las opciones de inferencia global y en Estados Unidos, el espacio de trabajo solo en Estados Unidos y el recargo de 1,1 veces. Leída el 28 de septiembre de 2026 y comprobada el 19 de octubre.
- Anthropic, página de Claude Sonnet: que cualquiera puede usar Sonnet 5.5 en Claude.ai, en web, iOS y Android. Leída el 28 de septiembre de 2026.
- Claude, planes y precios: qué familias de modelos incluye cada plan (Sonnet en Free, Pro y Max; Opus solo en los de pago). Leída el 28 de septiembre de 2026.
- Claude, por qué cambió de modelo tu conversación con Sonnet 5.5: qué peticiones pasan a Sonnet 5 y cuáles se bloquean. Leída el 28 de septiembre de 2026.
- Claude, cambiar el modelo, el esfuerzo y el pensamiento: el menú de modelo junto al botón de enviar, el selector de esfuerzo de Sonnet 5.5 y que su pensamiento no se apaga en la app. Leída el 28 de septiembre de 2026.
- Claude Code, configuración de modelos: el modelo por defecto de cada plan y proveedor, a qué versión apunta el alias sonnet en cada uno, la versión mínima y el modo opusplan. Leída el 28 de septiembre de 2026 y comprobada el 19 de octubre.
- OpenAI, precios de la API: tarifas de GPT 6 Sol y su recargo por encima de 272.000 tokens de entrada. Leída el 22 de septiembre de 2026.
- OpenAI, anuncio de GPT 6.1 Sol: mejora de GPT 6 Sol con la tarifa de 2 y 10 USD por millón de tokens y la caché a 0,10 USD, 29 de septiembre de 2026. Ficha en la documentación de OpenAI, con el recargo por encima de 272.000 tokens, leída el mismo día.
- Fuente: Artificial Analysis (artificialanalysis.ai): índice de inteligencia v5 y coste por tarea por nivel de esfuerzo de Claude Sonnet 5.5 y Claude Opus 5.5; a máximo, de GPT 6.1 Sol, GPT 6 Astra y Claude Haiku 5.5, y a muy alto y alto, de GPT 6.1 Sol; Gemini 4 Carbon, a alto, el único esfuerzo medido. Leídos el 28 de octubre de 2026, al tipo del BCE de ese día, 1 euro por 1,1133 dólares. Las cifras de Claude Sonnet 5 son de la v4.3, leída el 28 de septiembre, la última que lo midió. Basado en datos de Artificial Analysis, leídos el 28 de octubre de 2026. Artificial Analysis no avala este análisis ni es responsable de él.
- Google, anuncio de Gemini 4 Carbon: 28 de octubre de 2026; su modelo más potente, primero para un grupo de ciberdefensores y después para los socios del programa Fairwind, sin fecha para el resto; tarifa de lanzamiento de 2 y 10 dólares por millón y de 4 y 20 después.
- Data API de Artificial Analysis: el índice de programación, sin medir (null) para Claude Sonnet 5.5 ni para Claude Opus 5.5 en ninguno de sus cinco esfuerzos, a 28 de septiembre de 2026.
- Banco Central Europeo, tipo de cambio de referencia: 1 euro = 1,1463 dólares estadounidenses el 22 de septiembre de 2026, usado en todas las conversiones de esta guía.
- Anthropic, anuncio de Claude Fable 5.2: 9 de noviembre de 2026; 8 y 40 dólares por millón de tokens, al tipo del BCE de ese día, 1 euro por 1,1193 dólares.
- Artificial Analysis, lectura del 9 de noviembre: Claude Fable 5.2 a bajo, alto y máximo: 53,9, 61,8 y 64,6, con 2,77 €, 8,11 € y 23,71 € por tarea. Artificial Analysis no avala este análisis ni es responsable de él.